什麼是 Inference?
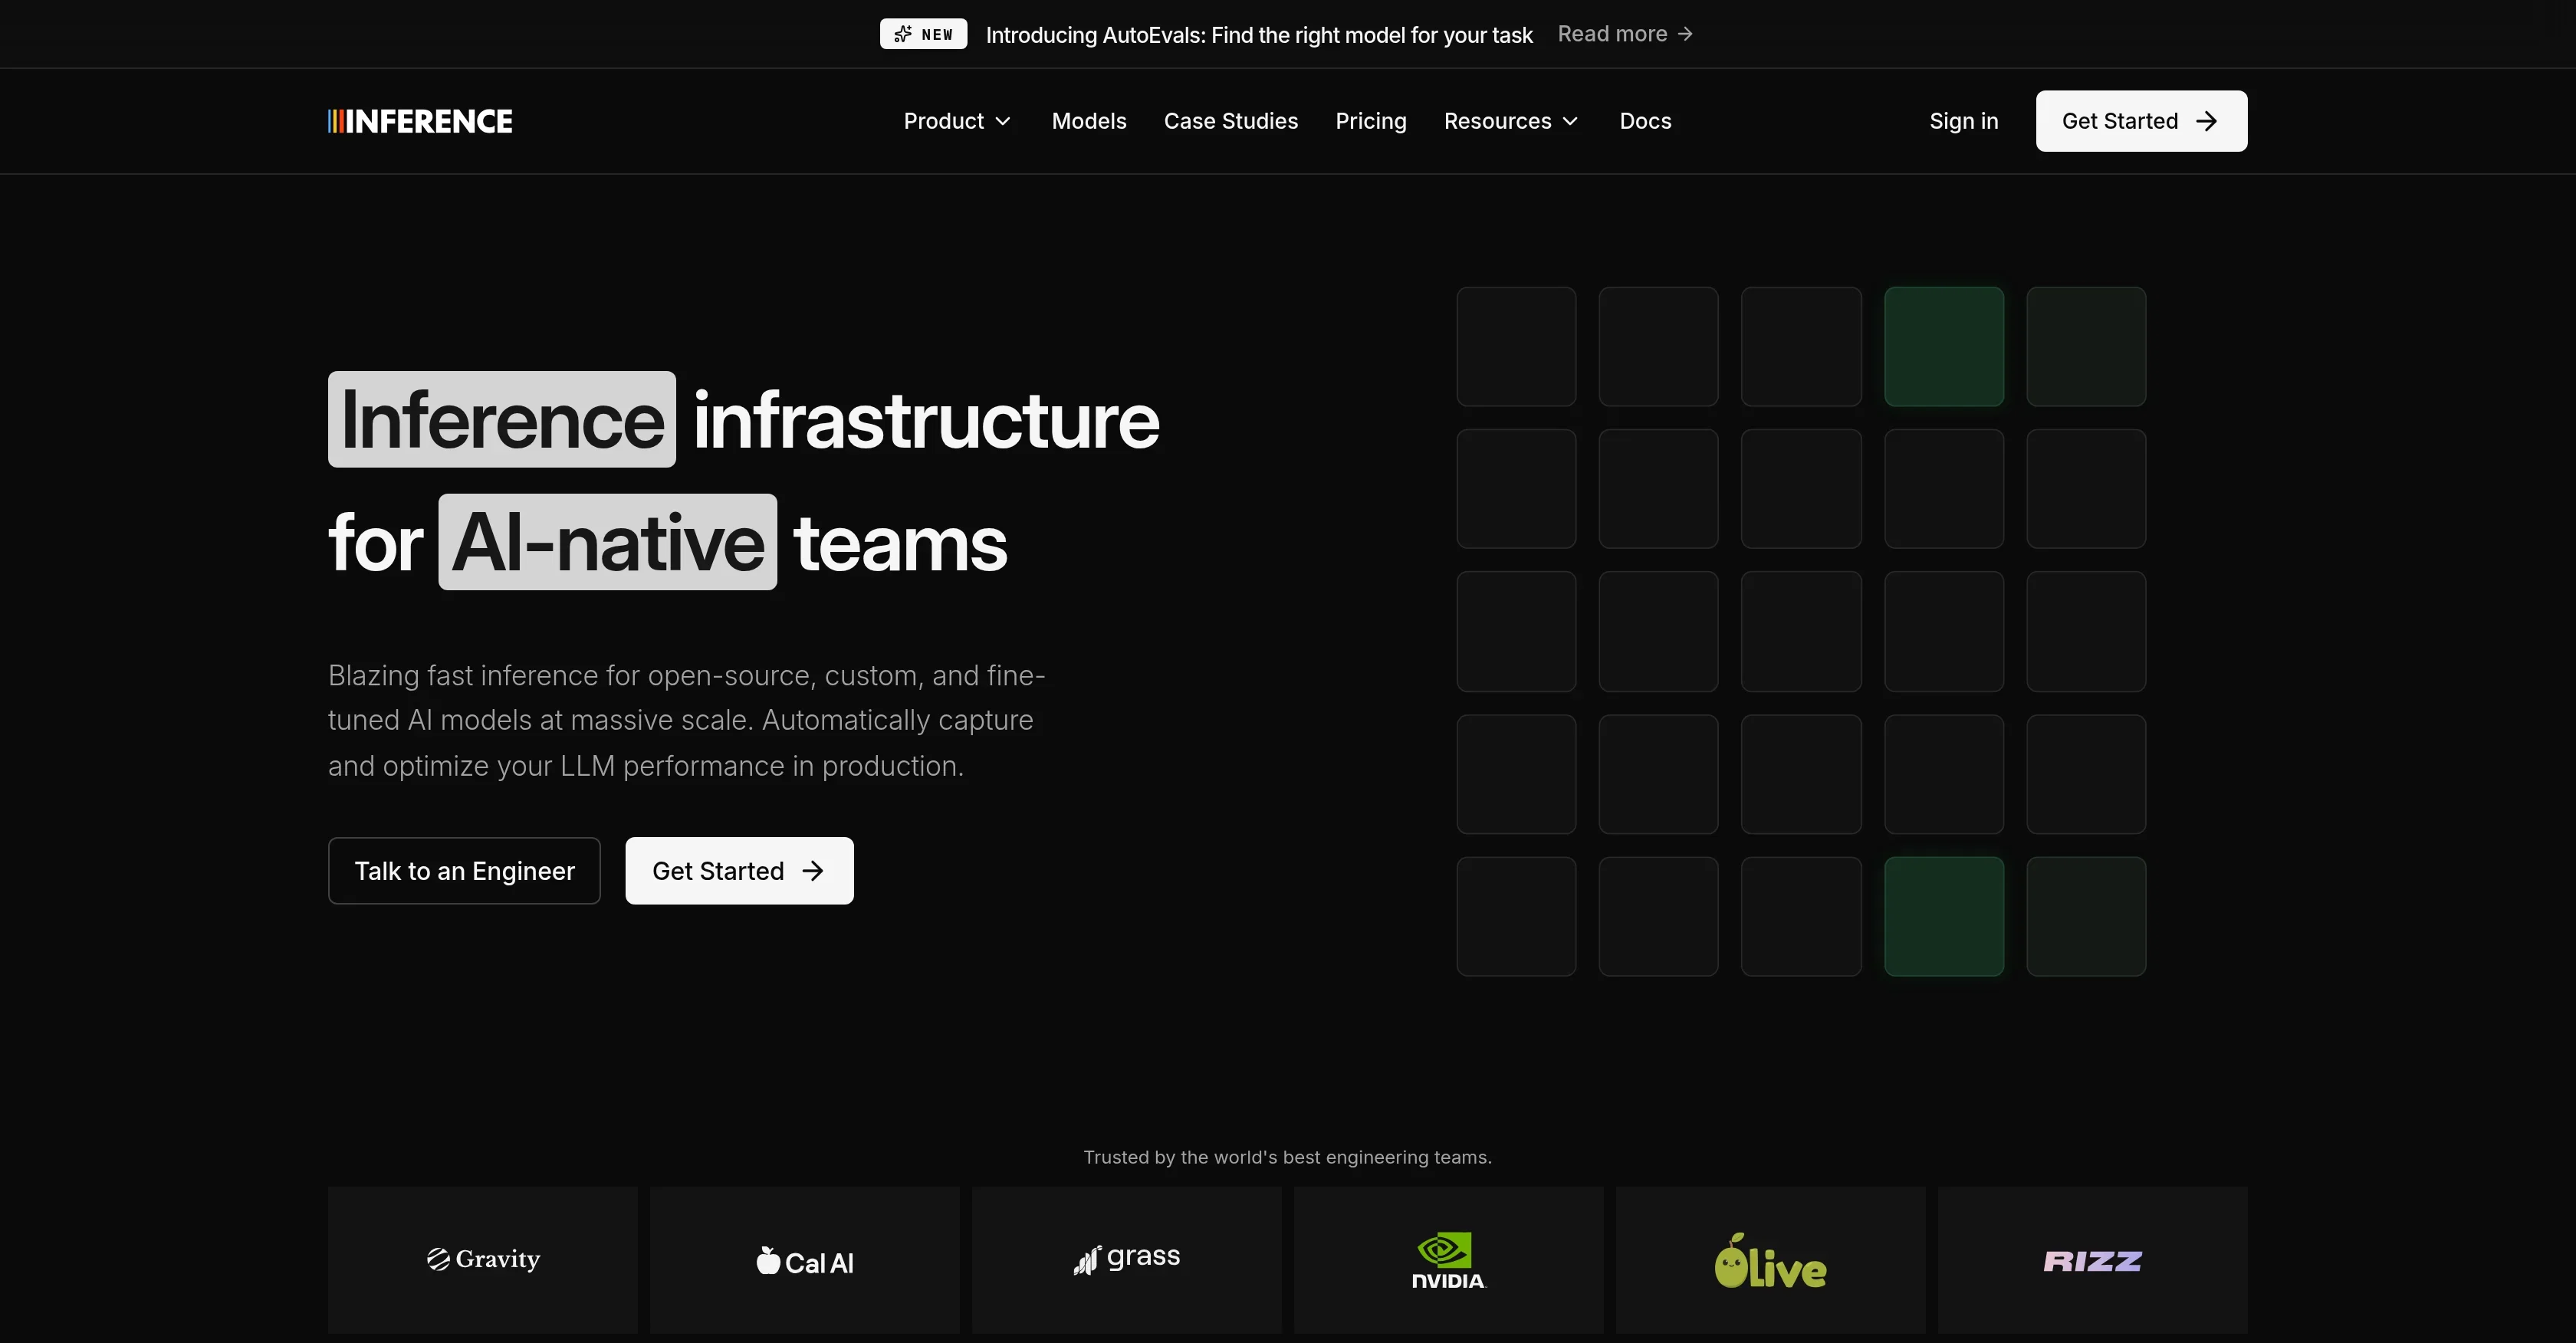
Inference.net 是一個面向 AI 原生團隊的全託管推論基礎設施平台。它讓你能夠在專用高效能基礎設施上部署開源、自訂和微調模型,透過統一閘道監控任意供應商的生產 LLM 流量,評估模型品質、成本和延遲,並根據你自己的資料微調專用模型。該平台旨在以 99.99% 正常運行時間和透明定價大規模提供前沿品質的模型服務。
如何使用 Inference?
- 1. 與工程師洽談,或從網站開始使用。2. 安裝 SDK,並將你的 LLM 流量指向 Inference.net 閘道,以擷取追蹤、延遲和成本資料。3. 從模型目錄部署模型,或在專用基礎設施上使用你自己的權重。4. 使用 Observe 和 Evaluate 監控跨供應商的品質、延遲和支出。5. 使用你的生產資料微調自訂模型,並將其直接推送到部署環境。
Inference 的核心功能
- Deploy:全託管、全球推論基礎設施,99.99% 正常運行時間,按小時計費的專用 GPU 定價
- Observe:透過單一閘道對任意模型或供應商進行 LLM 可觀測性與追蹤
- Evaluate:基於生產追蹤持續基準測試模型品質、延遲和成本
- Train:面向任務特定、前沿品質自訂模型的自動微調工作流程
- Trace:端到端擷取提示詞、工具呼叫、回應以及下游供應商行為
- HALO:開源代理最佳化,分析追蹤並對故障模式進行排序
- 模型目錄:部署開源模型,如 Kimi、MiniMax、GLM 和 GPT-OSS
- 符合 SOC 2 Type II,完全掌控資料和模型權重
用戶評價
5.0
/ 50 則評價
5 星
0
4 星
0
3 星
0
2 星
0
1 星
0
暫無評價,來寫第一條吧
相似產品

Inference 推廣元件
使用網站徽章展示您的產品已收錄於 Hootool,推動社群對工具發現與傳播的支持。推廣元件可輕鬆新增到首頁或頁尾。