什么是 Inference?
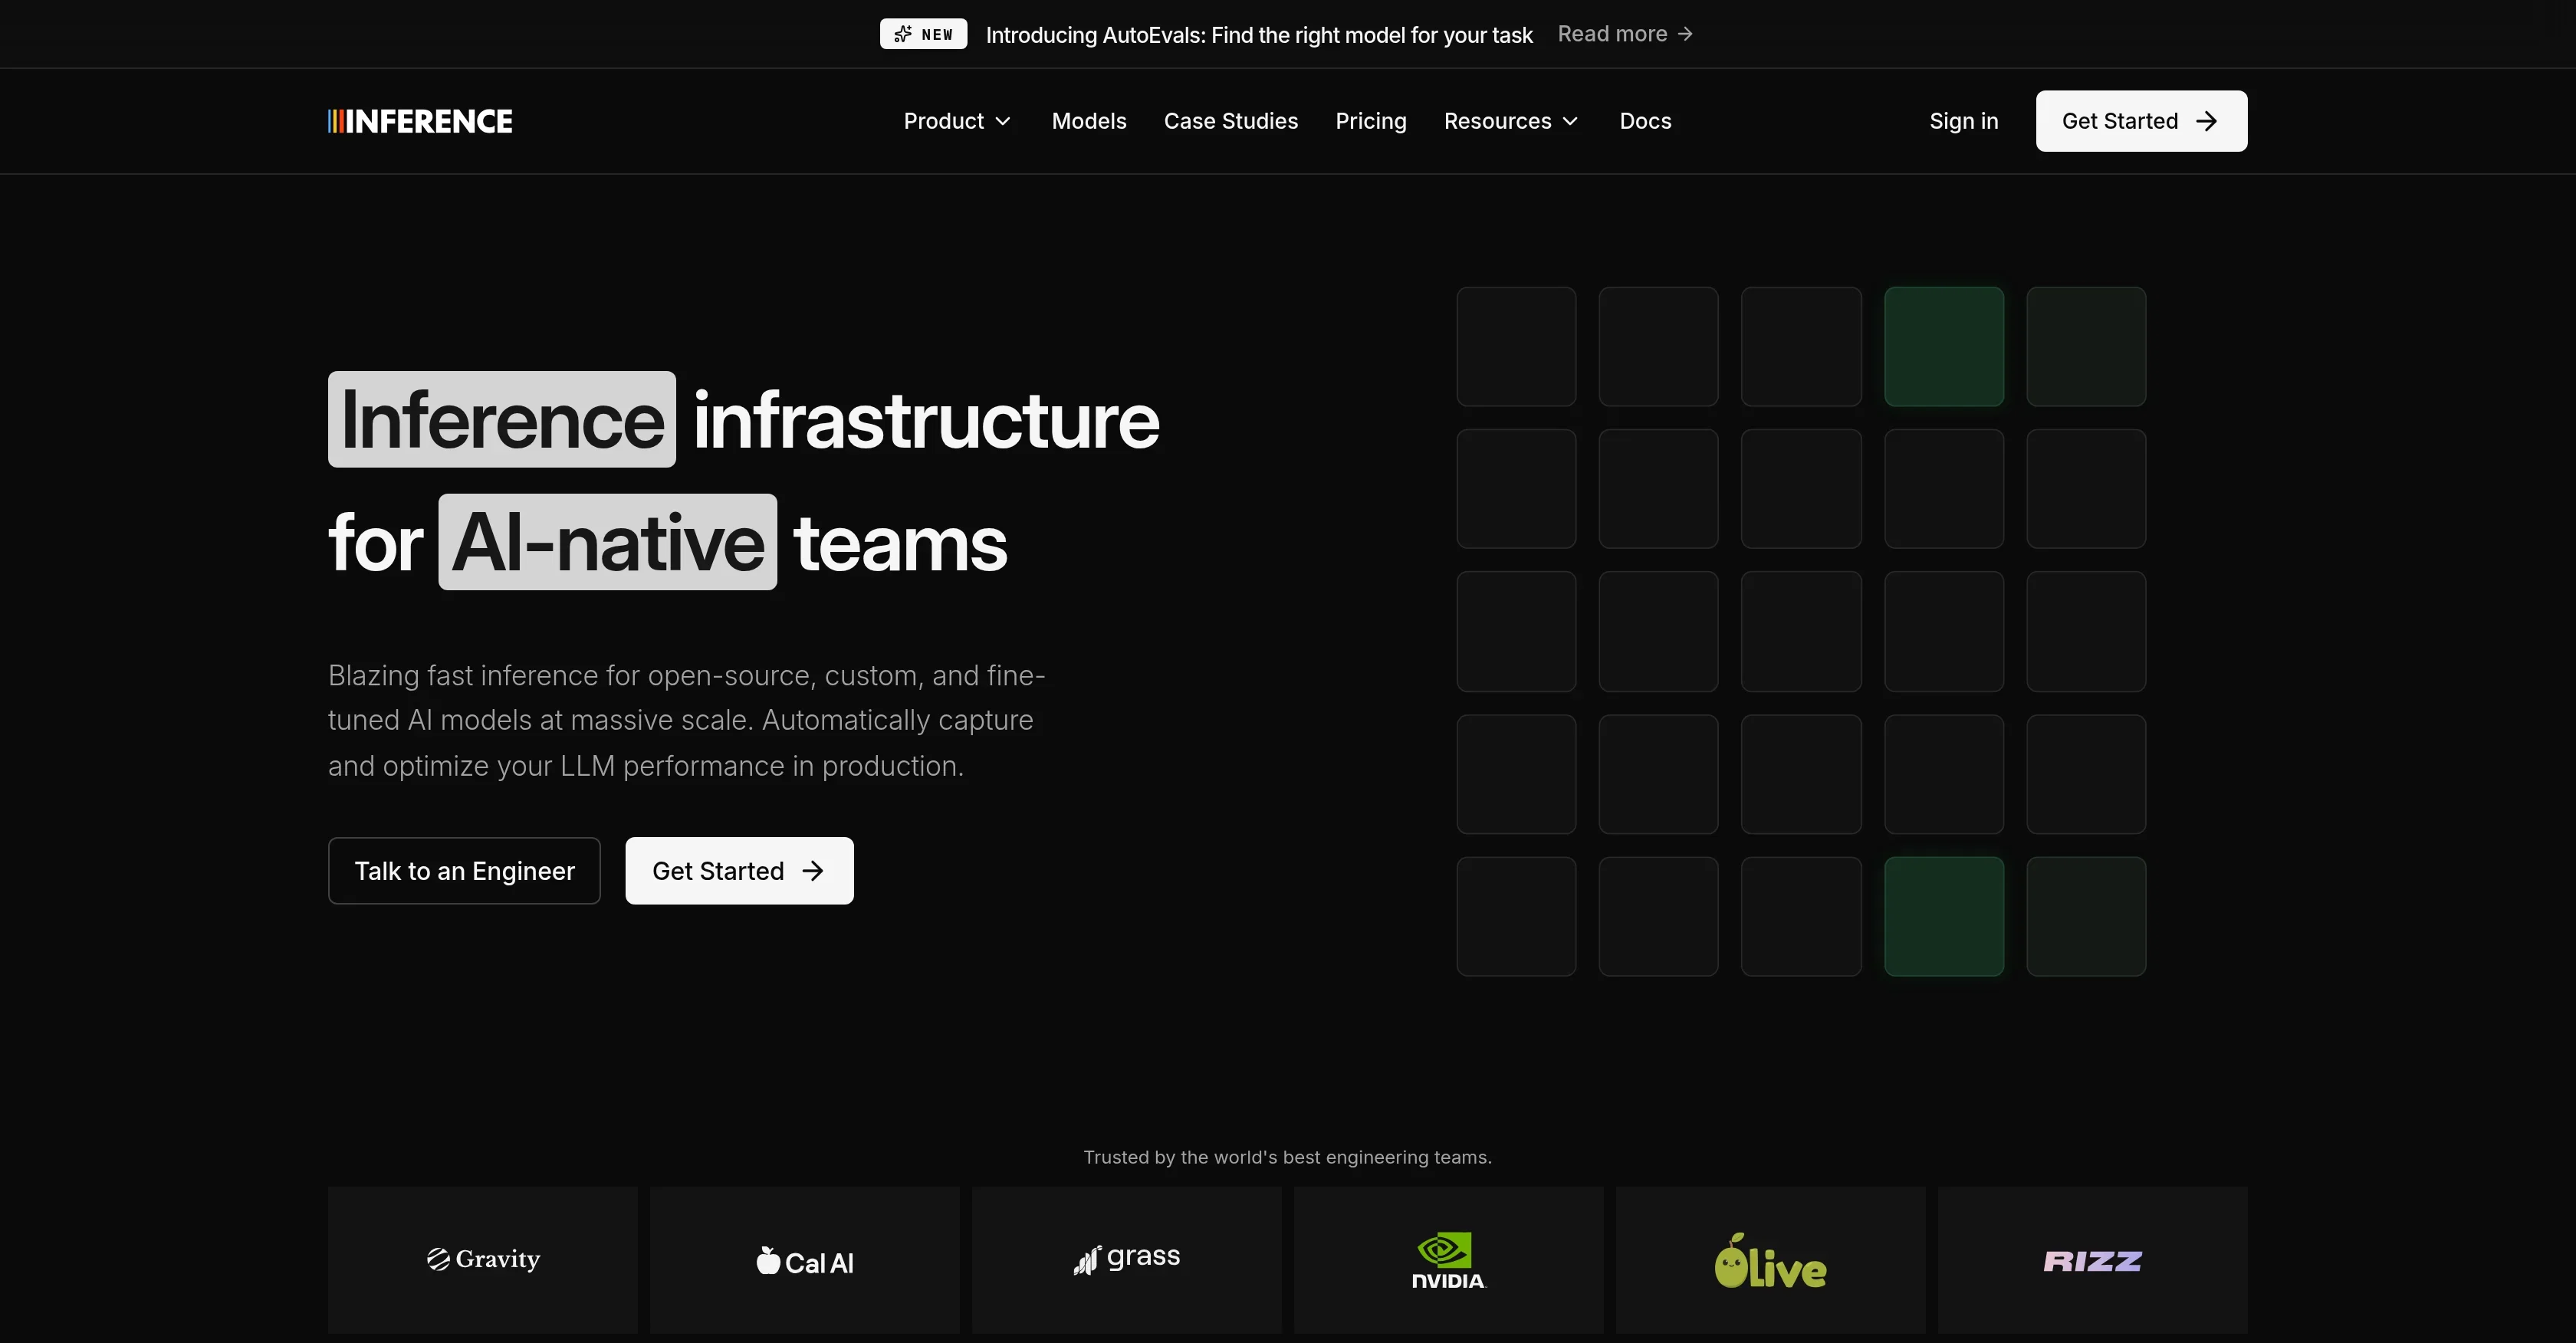
Inference.net 是一个面向 AI 原生团队的全托管推理基础设施平台。它让你能够在专用高性能基础设施上部署开源、自定义和微调模型,通过统一网关监控任意提供商的生产 LLM 流量,评估模型质量、成本和延迟,并基于你自己的数据微调专用模型。该平台旨在以 99.99% 正常运行时间和透明定价大规模提供前沿质量的模型服务。
如何使用 Inference?
- 1. 与工程师沟通,或从网站开始使用。2. 安装 SDK,并将你的 LLM 流量指向 Inference.net 网关,以捕获追踪、延迟和成本数据。3. 从模型目录部署模型,或在专用基础设施上使用你自己的权重。4. 使用 Observe 和 Evaluate 监控跨提供商的质量、延迟和支出。5. 使用你的生产数据微调自定义模型,并将其直接推送到部署环境。
Inference 的核心功能
- Deploy:全托管、全球推理基础设施,99.99% 正常运行时间,按小时计费的专用 GPU 定价
- Observe:通过单一网关对任意模型或提供商进行 LLM 可观测性与追踪
- Evaluate:基于生产追踪持续基准测试模型质量、延迟和成本
- Train:面向任务特定、前沿质量自定义模型的自动微调工作流
- Trace:端到端捕获提示词、工具调用、响应以及下游提供商行为
- HALO:开源智能体优化,分析追踪并对故障模式进行排序
- 模型目录:部署开源模型,如 Kimi、MiniMax、GLM 和 GPT-OSS
- 符合 SOC 2 Type II,完全掌控数据和模型权重
用户评价
5.0
/ 50 条评价
5 星
0
4 星
0
3 星
0
2 星
0
1 星
0
暂无评价,来写第一条吧
相似产品

Inference 推广组件
使用网站徽章展示您的产品已收录于 Hootool,帮助更多人按问题找到合适的 AI 工具。推广组件可轻松添加到主页或页脚。