scikit-learn이란?
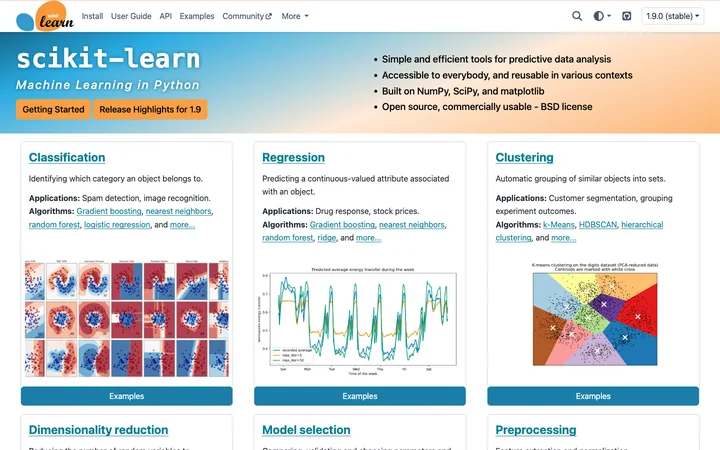
scikit-learn은 Python 프로그래밍 언어를 위한 오픈소스 머신러닝 라이브러리입니다. 서포트 벡터 머신, 랜덤 포레스트, 그래디언트 부스팅, k-means 및 DBSCAN을 포함한 다양한 분류, 회귀 및 클러스터링 알고리즘을 제공하며, Python의 수치 및 과학 라이브러리인 NumPy 및 SciPy와 상호 운용되도록 설계되었습니다.
scikit-learn 사용 방법
- pip 또는 conda를 통해 scikit-learn을 설치한 다음 Python 코드에서 가져옵니다. 이 라이브러리는 fit() 메서드로 모델을 피팅하고, predict()로 예측하며, transform()으로 데이터를 변환하는 일관된 인터페이스를 제공합니다. 공식 웹사이트에서 광범위한 문서와 튜토리얼을 이용할 수 있습니다.
scikit-learn의 핵심 기능
- 분류: 객체가 속한 범주를 식별합니다.
- 회귀: 객체와 관련된 연속 값 속성을 예측합니다.
- 클러스터링: 유사한 객체를 자동으로 집합으로 그룹화합니다.
- 차원 축소: 고려해야 할 확률 변수의 수를 줄입니다.
- 모델 선택: 매개변수와 모델을 비교, 검증 및 선택합니다.
- 전처리: 특징 추출 및 정규화.
사용자 리뷰
5.0
/ 5평가 0개
5점
0
4점
0
3점
0
2점
0
1점
0
아직 리뷰가 없습니다. 첫 리뷰를 남겨 보세요.
유사 제품
Modular
🇺🇸미국
05.0
CData
05.0
Cheaper Inference
Keak
🇺🇸미국
05.0
scikit-learn 임베드
웹사이트 배지로 제품이 Hootool에 등록되었음을 표시하고, 커뮤니티의 도구 발견과 공유를 응원하세요. 임베드는 홈페이지나 푸터에 쉽게 추가할 수 있습니다.